Yazılım ve Yapay Zekâ · ai · language model
Kimi K3.1 Pro: dev bir model, verilmiş bir söz
Moonshot AI, 23 Ekim 2026'da Kimi K3.1 Pro adlı bir dil modeli duyurdu. Öyle bir model ki bütün ağırlıklarını diske yazmaya kalkışsanız, eskiden bir makinenin tamamına yeten bellek o yığının içinde bir toz zerresi gibi kaybolur gider. Bu yazının dayanağı da belli: Moonshot'un kendi duyurusu, teknik belgeler ve bağımsız ölçüm sitelerinin yayımladığı sayılar. Bu dergide modeli kuran da çalıştıran da olmadı. O yüzden aşağıda "şöyle hızlıydı, böyle cevap verdi" türünden tek bir cümle bulamayacaksınız. Lafı uzatmadan başlayalım.
Nedir bu K3.1 Pro?
K3.1 serisinin ilk modeli. Kimi K3'ün üzerine ek eğitimle (post-training, yani temel eğitimden sonra yapılan ince ayar) kurulmuş bir halef. Moonshot onu "3T sınıfı açık ağırlıklı modellerimizin en yeteneklisi" diye tanıtıyor. Görsel ve video girdisi alıyor, araç çağırabiliyor (tool calling: model kendi başına bir fonksiyonu, bir aramayı, bir hesap makinesini devreye sokabiliyor). Bağlam penceresi 1.048.576 token, yani yuvarlak hesap bir milyon. Bu sayı Moonshot'un kendi blogunda yazıyor, tartışması yok.
Parametre sayısı ise biraz bulanık. Moonshot "3T sınıfı" demekle yetiniyor. Artificial Analysis ve Forklog 2,8 trilyon toplam, 104 milyar etkin parametre veriyor. Bu bir MoE tasarımına işaret ediyor (Mixture of Experts, uzmanlar karışımı: her token için modelin yalnızca küçük bir parçası çalışır). Ama dikkat! Bazı ikincil kaynaklar bu sayıların K3'ten aynen taşındığını söylüyor, Moonshot ise kesin bir rakam vermiyor. Ben bu sayıyı "büyük ihtimalle böyle" diye okuyorum, kesin bilgi diye değil.
Bir de şunu hesaplayın: parametre başına tek bayt ayırsanız bile 2,8 terabayt eder. Bir zamanlar 880K'lık disketlere program sığdırmak için kod sıkıştıranlar bu sayıyı görse ne derdi, bilemiyorum (herhalde önce bir bardak su isterdi).
"Açık ağırlık" dediğin ne zaman açılır?
Bu modelin en çok konuşulacak yanı burası. Moonshot tam ağırlıkların 4 Kasım'a kadar yayımlanacağını söylüyor. Bugün 28 Ekim, ağırlıklar henüz ortada yok. Lisans adı da verilmiş değil. llmreference modeli "restricted", yani kısıtlı olarak listeliyor. Açık ağırlık şimdilik bir söz, o kadar. Sözün tutulup tutulmadığını ve hangi lisansla tutulduğunu görmeden "açık model" etiketini rahatça yapıştırmak bence erken.
Peki bu neden önemli? Çünkü açık ağırlık, modeli kendi donanımınızda çalıştırabilmeniz, inceleyebilmeniz, üzerine eğitim yapabilmeniz demek. Lisans ticari kullanımı yasaklıyorsa ya da dağıtıma kısıt koyuyorsa elinizdeki dosya bir müze parçasına döner: bakarsınız, dokunamazsınız. Ağırlıklar çıktığında lisans metnini MUTLAKA baştan sona okuyun. Benden söylemesi.
Fiyat ve veri
API fiyatı milyon girdi token'ı başına 2 dolar, milyon çıktı token'ı başına 10 dolar. Önbelleğe alınmış girdi 0,20 dolar, yani yüzde 90 indirim. Bu fiyatı Artificial Analysis ve OpenRouter listeliyor. Moonshot'un blogu ise yalnızca fiyat sayfasına bağlantı veriyor. Fiyatı gizlemiyorlar, ama duyurunun içine de koymamışlar. Ufak bir titizlik eksiği.
Önbellek indirimi kâğıt üstünde oldukça cömert. Uzun bir belgeyi ya da büyük bir kod deposunu tekrar tekrar modele okutan biri için asıl fatura kalemi girdi olur. Bir milyonluk bağlam penceresiyle bu indirim birlikte düşünülmüş gibi duruyor.
Veri tarafında API müşterilerine Zero Data Retention (sıfır veri saklama: gönderdiğiniz içerik sunucuda tutulmaz) sağlanıyor. Kimi Enterprise'da model varsayılan olarak kapalı geliyor, bir yönetici açana kadar kimse kullanamıyor. Kurumsal tarafta "önce sor, sonra aç" yaklaşımı yerinde bir karar.
Bir de kimi-k3.1-pro-highspeed adlı bir sürümden söz ediliyor. Aynı yeteneklerle iki üç kat hızlı çalıştığı, buna karşılık yaklaşık iki kat kota harcadığı yazılıyor. Bu bilgi ikincil kaynaklardan geliyor, Moonshot'un blogunda doğrulanmış değil. Kesin bilgi gibi okumayın.
Kendi sınavını kendi okuyan öğrenci
Moonshot'un yayımladığı sayılara bakalım:
- Terminal-Bench 4.0: yüzde 65,7. Aynı tabloda Opus 5.5 yüzde 66,4, GPT-6 Astra yüzde 58,2.
- Kimi Code Bench 3.0, uzun soluklu görevler: yüzde 61,2. K3'te bu sayı 55,95'ti.
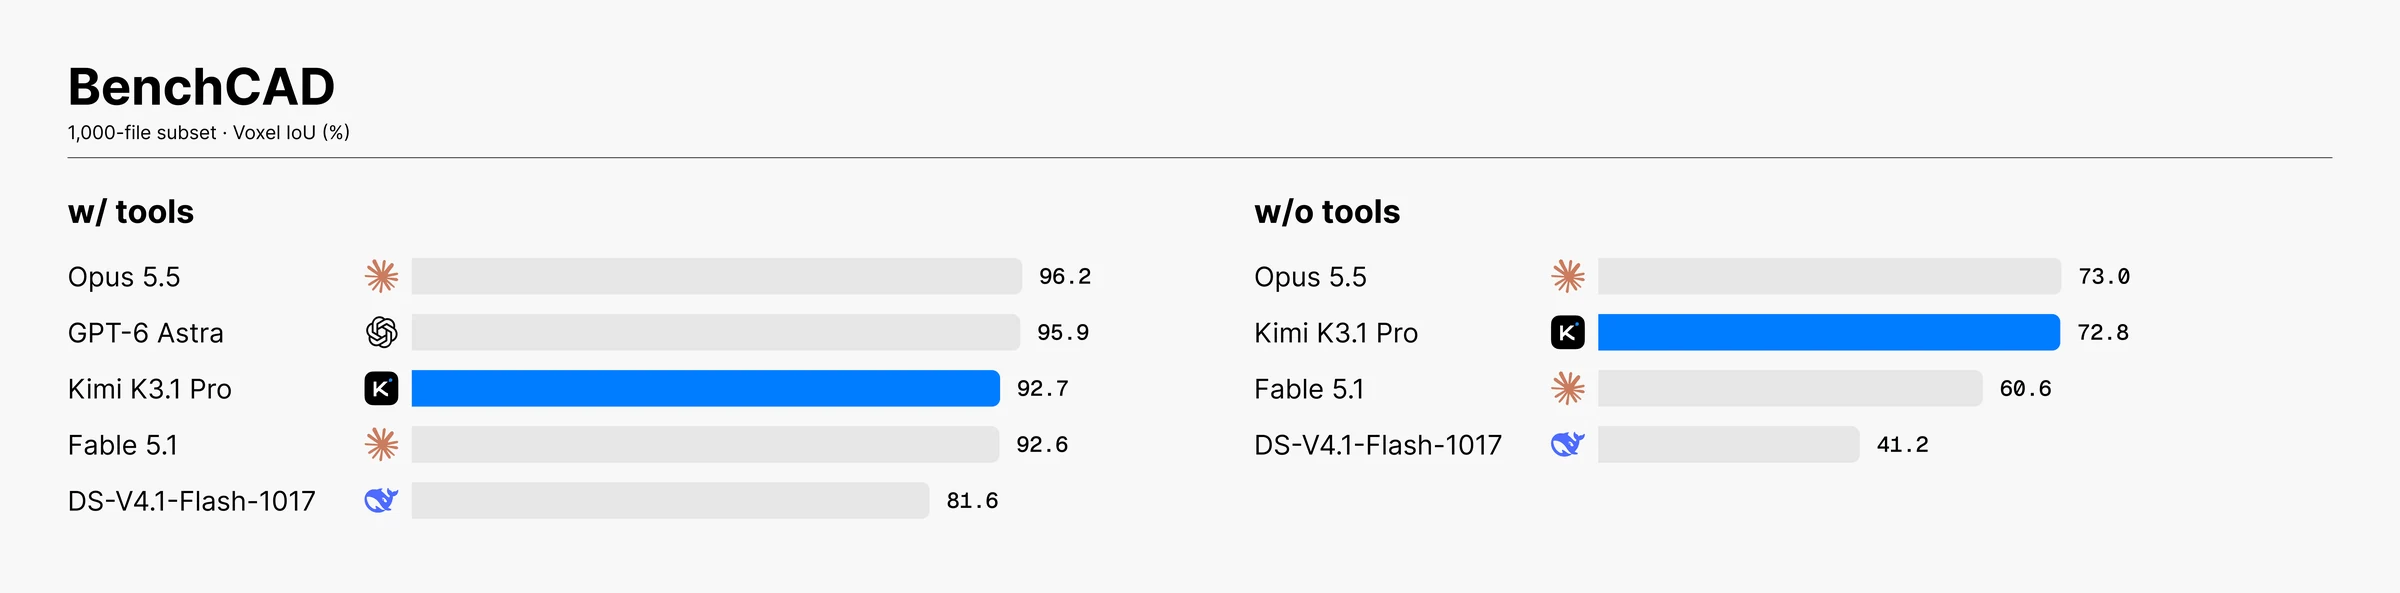
- BenchCAD: araçlarla yüzde 92,7 (Opus 5.5 yüzde 96,2), araçsız yüzde 72,8.
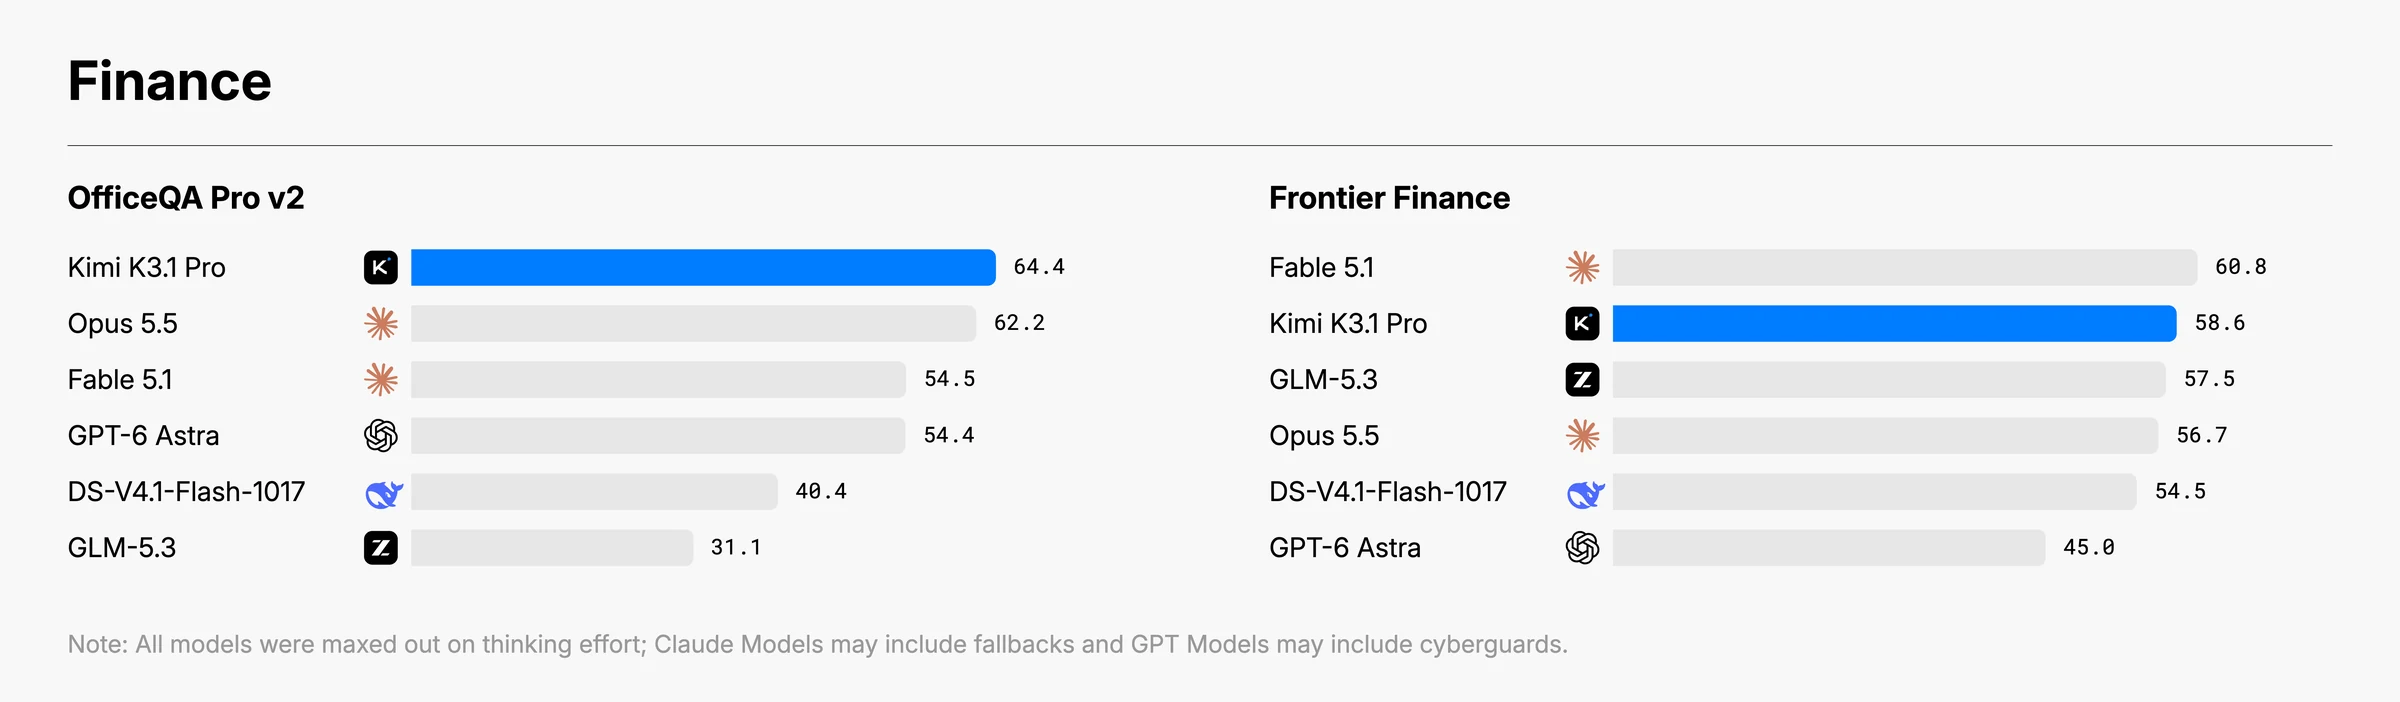
- OfficeQA Pro v2: 64,4. Moonshot bunun alanındaki en iyi sonuç olduğunu söylüyor.
- Kimi Hallu Bench Hard: iddia düzeyinde halüsinasyon oranı yüzde 8,3. K3'te yüzde 23,4'tü.
Son satır kâğıt üzerinde en çarpıcısı: uydurma oranının üçte birin altına inmesi. Ama testin adına bir daha bakın. Kimi Hallu Bench, Kimi Code Bench... Sınavı hazırlayan da, uygulayan da, notu veren de aynı ev. Bu sayıların yanlış olduğunu söylemiyorum, doğrulayacak bağımsız bir çalışma bulunamadığını söylüyorum. Elle denenmiş, bağımsız bir inceleme de henüz ortada yok.
Bağımsız ölçümler ne diyor?
Burada tablo biraz daha ayık. Artificial Analysis'in Intelligence Index'inde model 55 puan almış ve model sayfasında 221 model arasında 4. sırada görünüyor. Aynı kuruluşun tam listesinde, efor seviyeleri ayrı satırlarda sayıldığında, önünde dört satır var: en yüksek eforda Claude Opus 5.5 (58), ardından 56 puanla üç girdi (Claude Sonnet 5.5 max, Opus 5.5 xhigh ve Muse Wonder Full max). Kimi K3.1 Pro hemen ardından geliyor. "Opus 5.5'in az gerisinde" demek haksızlık olmaz, ama aradaki üç puan da yok sayılacak kadar küçük değil.
Vals AI'da ise tablo farklı: Vals Index'te yüzde 62,52 ile 27 model arasında 8. sırada. İki bağımsız ölçüm arasındaki bu fark bir şey anlatıyor: model her ölçümde en üst sıraya yerleşmiyor. Hangi işe koştuğunuza göre sıralaması dört basamak birden oynayabiliyor.
Kendi silahını köreltmek
Yazının en ilginç kısmına geldik. Moonshot, siber saldırıyla ilgili verileri hem ara eğitimden (mid-training) hem de pekiştirmeli öğrenme (RL, Reinforcement Learning) aşamasından çıkardığını söylüyor. Bunun bedelini de rakamla yazmış: kendi xdev-bench-hard testinde (pass@3, yani üç denemeden biri tutarsa başarılı sayılıyor) bu önlemler alınmamış ara sürüm yüzde 90,5 alırken son model yüzde 81,0'de kalmış. Yaklaşık 9,5 puanlık bir kayıp.
Bir şirketin "modelimizi şu konuda bilerek zayıflattık, işte ne kadar zayıfladığı" demesi pek sık görülmüyor. Sayı yine kendi testlerinden geliyor, yani yukarıdaki ihtiyat burada da geçerli. Ama bedeli açıkça yazmak, bedelsizmiş gibi davranmaktan çok daha dürüst. Bu tavrı takdir ediyorum.
Kime göre?
Moonshot'un öne sürdüğü kullanım alanları kodlama, "3D Make" adını verdiği 3D/CAD üretimi, finansal modelleme ile araştırma ve iş operasyonları. BenchCAD sayıları ikinci maddeyi destekliyor. Özellikle araçlı ve araçsız sonuç arasındaki yirmi puana yakın fark, modelin bu işte araca ne kadar yaslandığını gösteriyor. Terminal-Bench ile uzun soluklu kod testi de ilk maddeye uyuyor.
Hükmüme gelince: K3.1 Pro, bağımsız ölçümlerde en üst sıraların hemen altında duran, fiyatı ve önbellek indirimiyle uzun bağlamlı işler için hesaplı görünen, kendi zayıflatıldığı noktayı rakamla açıklayan ciddi bir model. Moonshot'un kendi testlerindeki parlak sayılar ise bağımsız biri dokunana kadar vitrin malı. "Açık ağırlık" sıfatını da 4 Kasım'dan önce kullanmam. Ağırlıklar o tarihte gelir, lisans makul çıkarsa, bu yılın en önemli açık model duyurularından biri olur. Gelmezse elimizde iyi ama kapalı bir API kalır, o kadar.
Ağırlıklar yayımlandığında lisansa da, ilk bağımsız denemelere de yeniden bakacağım. Bu arada modeli kendi işinize koşan varsa yazın, ne gördüğünüzü merak ediyorum. Gelecek ay görüşmek üzere, esen kalın!
Kaynaklar
- Birincil kaynak kimi.com